
GPT-6 Astra 和 GPT-5.6 Sol 怎么选?能力、额度与成本对比
Astra 更适合最困难的端到端任务、多工具协作和长时间推理;Sol 更适合复杂但边界清楚的专业工作,也能用更少额度完成更多轮尝试。两者都提供 105 万 token 上下文与 12.8 万 token 最大输出,但 Astra 的 API 单价和 ChatGPT credits 消耗率都是 Sol 的 2.5 倍。
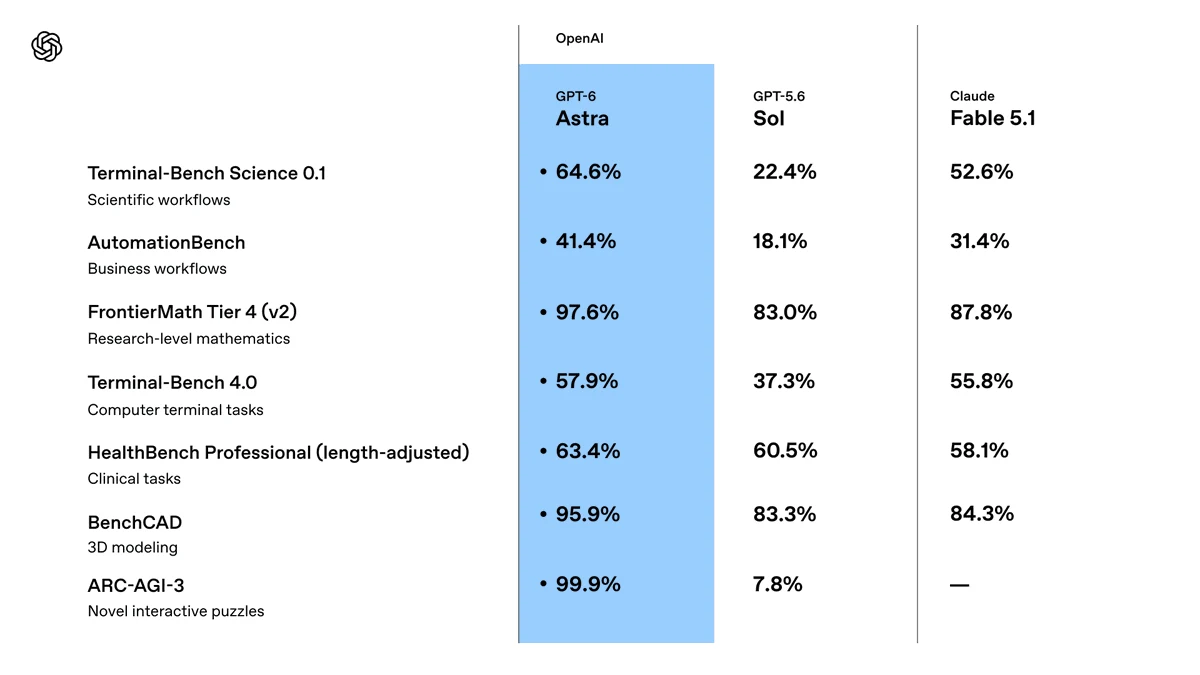
OpenAI 公布的部分基准结果。分数只代表对应测试,不等于 Astra 在每个真实任务上都会按同样幅度领先。
开始阅读先看结论:难题选 Astra,日常复杂任务先用 Sol
9 月 22 日更新:GPT-6 Sol 已发布。Sol 这一侧现在优先用 GPT-6 Sol,它的 API 价格只有 GPT-5.6 Sol 的一半,官方测试中的事实错误也少了约一半。
跨多个工具、需要长时间自主推进并反复验证的高难度任务,优先尝试 GPT-6 Astra。
需求边界清楚、希望多轮迭代或控制额度消耗的复杂专业任务,先用 Sol 通常更划算。
Astra 在代理、科研、终端类测试上领先很多,但在 GPQA Diamond 这类知识题上只高一两个点,不是每件事都强一大截。
Work 与 Codex 中,Astra 会更快消耗两者共用的任务额度;先用最低可满足结果的模型和推理档位。
GPT-6 Astra 与 GPT-5.6 Sol 核心区别
ChatGPT 任务额度与 API token 价格是两套体系。下表分别列出,不能互相换算。消息数为 OpenAI 在 2026 年 9 月 4 日给出的本地任务估算,并非固定上限。
左右滑动查看完整表格
| 比较项 | GPT-6 Astra | GPT-5.6 Sol | 选择建议 |
|---|---|---|---|
| 官方定位 | 最困难的端到端工作 | 复杂专业工作 | 任务越长、工具越多,Astra 的价值越明显 |
| 典型任务 | 大型工程、复杂代理、科研流程、跨工具执行 | 功能开发、代码审查、分析、写作与反复打磨 | 边界清楚先用 Sol;困难链路再切 Astra |
| 上下文 / 最大输出 | 105 万 / 12.8 万 token | 105 万 / 12.8 万 token | 容量相同,不要只因文件大就默认选 Astra |
| API 标准价格 / 百万 token | 输入 $10;缓存输入 $1;输出 $50 | 输入 $4;缓存输入 $0.40;输出 $20 | Astra 单价是 Sol 的 2.5 倍 |
| ChatGPT credits / 百万 token | 输入 250;缓存输入 25;输出 1250 | 输入 100;缓存输入 10;输出 500 | Astra 的 credits 消耗率是 Sol 的 2.5 倍 |
| Plus 本地消息估算 / 5 小时(9 月下旬) | 约 5–45 条 | 约 10–100 条 | 实际消耗取决于任务、上下文、推理和工具 |
9 月 22 日更新:现在该拿 Astra 和 GPT-6 Sol 比
这篇文章写于 GPT-6 Sol 发布之前,比较的是 Astra 和 GPT-5.6 Sol。9 月 22 日 OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna,在 Work 和 Codex 里对 Plus 及以上开放,情况变了:GPT-6 Sol 的 API 价格是 $2 / $10,只有 GPT-5.6 Sol 的一半、Astra 的五分之一;Plus 在 Codex 里每 5 小时约能发 15–150 条,比 GPT-5.6 Sol 的 10–100 条还多。
下面“难题选 Astra、日常先用 Sol”的思路不变,只是 Sol 这一侧,能选 GPT-6 Sol 就优先选它。新模型的价格、额度和跑分对比,单独写在另一篇里。
查看 GPT-6 Sol、Luna 与 Astra 怎么选→Astra 更强,但不是每个任务都该选 Astra
OpenAI 将 GPT-6 Astra 定位为“最困难的端到端工作”模型,将 GPT-5.6 Sol 定位为“复杂专业工作”模型。两者并不是简单的新旧替代关系:Astra 把更多算力和自主执行能力用在长链路难题上,Sol 则保留了足够高的能力,同时让同一份任务额度支持更多轮尝试。
如果任务可以在一句话里说明验收结果、只涉及少量文件或只需要一次分析,先用 Sol 更合理。只有当任务需要跨多个工具、处理大量相互依赖的信息、持续推进并自行验证时,Astra 的能力优势才更可能抵消额外消耗。
官方基准:复杂代理任务差距大,部分知识题差距小
OpenAI 公布的结果中,Astra 在 Terminal-Bench 4.0 上为 57.9%,Sol 为 37.3%;在 AutomationBench 上为 41.4% 对 18.1%;在 Terminal-Bench Science 0.1 上为 64.6% 对 22.4%。这些测试都要求模型在真实软件或终端环境中完成多步骤工作,正好对应 Astra 的核心定位。
差距并非处处都这么大。Agents’ Last Exam 是 59.3% 对 53.6%,GPQA Diamond 是 96.0% 对 94.6%,BrowseComp 是 91.5% 对 90.4%。这说明“更难的代理链路优先 Astra”比“Astra 所有问题都明显更好”更接近官方数据。
基准成绩还会受推理档位、工具、评测环境和成本设置影响。最有用的读法不是背总分,而是判断你的工作更接近哪类测试。
- 终端、科研流程、自动化和大型工程:Astra 的公开优势更明显。
- 知识问答、网页检索和已有流程内的专业任务:Sol 与 Astra 的差距可能较小。
- 真实选择还要同时看完成率、耗时、人工返工和额度消耗。
额度与成本:Astra 的单次投入更高
在 ChatGPT Work 与 Codex 中,两款模型消耗同一份任务额度,但不是简单地“发一条扣一条”。OpenAI 会根据任务、输入输出长度、推理设置、工具调用和 Fast mode 计算消耗。按官方的本地消息估算,Plus 使用 Astra 每 5 小时约 5–45 条,使用 GPT-5.6 Sol 约 10–100 条。Pro 没有 5 小时限制,9 月 29 日起按 Plus 的 5、10、25 倍计算。
如果通过 API 使用,差别更直接:Astra 每百万输入 / 输出 token 为 $10 / $50,Sol 为 $4 / $20;缓存输入分别为 $1 和 $0.40。两者标准费率正好相差 2.5 倍。长上下文请求还可能触发额外费率,因此批量处理和多轮代理任务更需要先做成本测试。
这不代表 Astra 完成一项工作一定贵 2.5 倍。官方发布页展示了一些 Astra 因更少输出、更高一次成功率而降低“每个成功任务成本”的例子;但这只适用于对应配置和评测。自己的工作流仍应按完成一次合格结果的总成本来比较。
查看 Astra 在 Chat、Work 与 Codex 中的完整额度规则→这些任务优先尝试 GPT-6 Astra
Astra 最适合“不能只生成答案,还要把整件事做完”的任务。它的优势集中在长时间自主推进、使用多个工具、维护复杂状态和发现错误后继续修正。
- 跨仓库或跨模块的大型功能,需要读代码、修改、运行测试并处理失败。
- 科研和数据任务,需要调用终端、分析数据、运行模拟并解释结果。
- 长文档或大型上下文中的多步判断,前后约束不能丢失。
- 浏览器、桌面或专业软件操作,需要连续观察界面并执行动作。
- Sol 已经多次卡住、漏掉关键依赖或需要大量人工接管的任务。
这些任务先用 GPT-5.6 Sol
Sol 不是“低配 Astra”。OpenAI 仍把它列为复杂专业工作的旗舰模型,而且它与 Astra 拥有相同的 105 万 token 上下文和 12.8 万 token 最大输出。对于边界清楚的高价值任务,Sol 往往能以更低消耗完成工作。
- 单个功能、明确 bug、代码审查、测试补充和范围清楚的重构。
- 报告、邮件、方案和文案的分析、改写与多轮打磨。
- 需要连续尝试多个方向,但每一轮任务本身并不复杂。
- 预算或任务额度有限,希望先获得可用结果,再决定是否升级模型。
- Astra 与 Sol 在你的实际验收标准上结果接近。
最实用的比较方法:拿同一个真实任务做 A/B 测试
不要用“感觉更聪明”判断模型。选一个你真正会重复做、且能明确验收的任务,把同一份输入、文件范围、推理档位和工具权限分别交给 Astra 与 Sol。记录是否一次完成、总耗时、返工次数和消耗,再决定默认模型。
建议先让 Sol 完成;结果不达标时,把完全相同的任务交给 Astra。这样可以看见 Astra 是否真的减少返工,而不是把模型升级后的新鲜感误当成能力差异。
- 固定输入:同一提示、同一代码或文档版本。
- 固定条件:相同推理档位、工具权限和验收命令。
- 记录结果:一次成功率、耗时、人工修改量和任务额度。
- 按任务分类保存结论,不用一场测试决定所有工作。
普通 Chat 与 Work / Codex 的模型入口不同
普通 ChatGPT 对话里,Astra 以 GPT-6 Pro 的名字出现,Plus 没有;在 Work 与 Codex 里,Plus 有有限的 Astra 用量,也能用 Sol。本文讲的选择和额度,说的都是 Work 与 Codex。普通对话 10 月 7 日起的默认模型已经换成 GPT-6,背后是 GPT-6 Sol,Plus 可以用到 High 档。
先核对你的套餐与入口→Plus 还是 Pro 5×:按实际触限频率选择
只是比较 Astra 与 Sol,或偶尔执行长任务,Plus 可以先开始。已经是 Plus 用户,而且任务额度持续打断日常工作时,再考虑 Pro 5×;换套餐增加使用空间,任务本身仍要选择合适的模型与推理档位。
AONIR 的 Plus 为 ¥168 / 月,Pro 5× 为 ¥730 / 月,均支持微信自助充值到本人账号。10×(Pro 200)由客服开通,请联系客服充值。
充值 ChatGPT Pro 5× · ¥730 / 月→你可能还想知道
01GPT-6 Sol 出来后,还要用 GPT-5.6 Sol 吗?
能选到 GPT-6 Sol 就优先用它:API 价格是 GPT-5.6 Sol 的一半,官方测试中的事实错误约少一半,Plus 在 Codex 里每 5 小时能发的条数也更多。GPT-5.6 Sol 在推广期间仍可选择。
02GPT-6 Astra 一定比 GPT-5.6 Sol 强吗?
Astra 在 OpenAI 公布的多项复杂代理、终端、科研和自动化基准上领先,但部分知识、检索和专业测试的差距较小。真实任务还受提示、工具、推理档位和验收标准影响,不能把一项基准外推到所有工作。
03写代码应该选 Astra 还是 Sol?
跨模块大型功能、长时间自主执行、需要反复测试和处理失败时优先尝试 Astra;明确 bug、单个功能、代码审查和范围清楚的修改先用 Sol。最可靠的方法是用同一真实任务比较一次成功率、返工和额度消耗。
04ChatGPT Plus 可以同时使用 Astra 和 Sol 吗?
在 Work 与 Codex 中,Plus 可以使用 GPT-5.6 Sol,并获得有限的 GPT-6 Astra 任务额度。普通 Chat 中,Astra 显示为 GPT-6 Pro,Plus 不包含该 Chat 选项。
05为什么 Astra 比 Sol 更快消耗任务额度?
Astra 面向更困难的端到端任务,官方公布的 ChatGPT credits 消耗率是 Sol 的 2.5 倍。实际消耗还会随任务长度、输入输出、推理设置、工具调用和 Fast mode 变化,因此不能按固定对话次数计算。
06Astra 与 Sol 的 API 上下文一样大吗?
一样。两者当前都提供 1,050,000 token 上下文窗口和 128,000 token 最大输出;区别主要在能力定位、知识截止时间和价格。Astra 标准输入 / 输出价格为每百万 token $10 / $50,Sol 为 $4 / $20。
07日常任务应该一直使用 Astra 吗?
不建议默认这样做。先用 Sol 和较低推理档位完成边界清楚的任务;当结果持续不达标、任务链路很长或需要多工具自主执行时再切 Astra。这样更容易平衡结果、速度与额度。
有据可查,方便追溯
2026 年 9 月 30 日:按 DevDay 后的规则更新 Pro 额度(没有 5 小时限制,按 Plus 的 5、10、25 倍算)。9 月 23 日:GPT-6 Sol / Luna 已发布,补充新模型的选择建议;对照 ChatGPT Learn 定价页复核额度估算,数值未变。模型基准和案例保留 9 月 4 日核对日期。